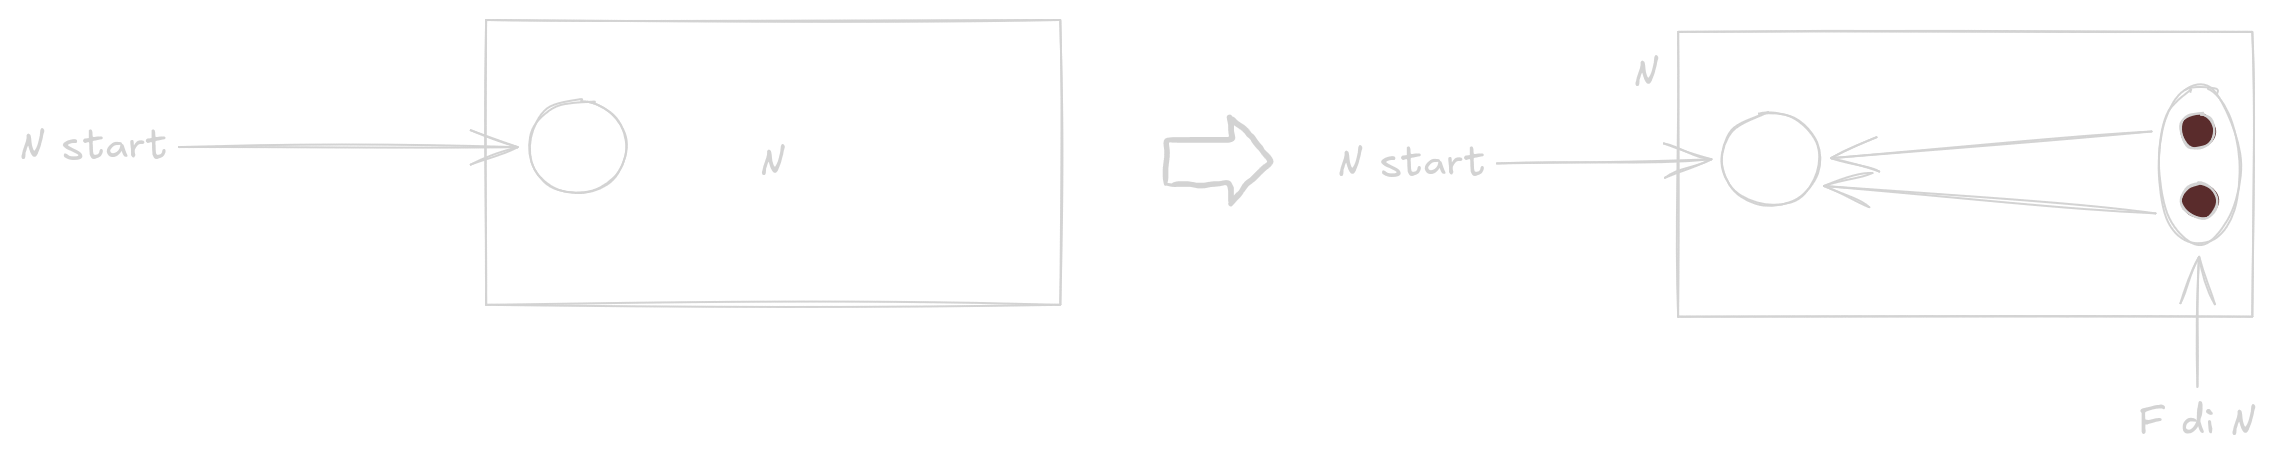
Classe REG dei linguaggi
Un linguaggio è regolare se esiste un macchina a stati finiti che ne riconosce tutte le stringhe.
significa che l’automa riconosce .
Definire un linguaggio regolare tramite la funzione di transizione estesa
Per definire rigorosamente un , cioè il linguaggio regolare associato ad un DFA, si usa la funzione di transizione estesa.
Così un linguaggio regolare si può definire come l’insieme .
Delta star si può definire ricorsivamente in modo elegante partendo da :
N.B.: La stringa vuota sta in (Star di Kleene di ) per definizione, ma non per forza nel linguaggio, che è un sottoinsieme di .
Il linguaggio riconosciuto da un DFA è .
Proprietà dei linguaggi regolari
I linguaggi regolari hanno una chiusura rispetto ad alcune operazioni:
- unione:
- intersezione:
- complemento:
- concatenazione: dati e , si ha = ; ricorsivamente:
- potenza (è tipo il prodotto cartesiano):
Per i linguaggi
Dimostrazioni
Unione
- Tesi: e
- Ipotesi:
Si assume che .
Difficoltà: non posso eseguire e su e vedere che succede. In qualche modo invece, bisogna costruire un DFA che li “esegue in parallelo”.
Devo definire tale che:
- (se uno dei due stati o sono finali non ci interessa dell’altro, stiamo ragionando sull’unione)
Il resto della dimostrazione è inutile per il corso.
Ri-dimostrazioni usando gli NFA
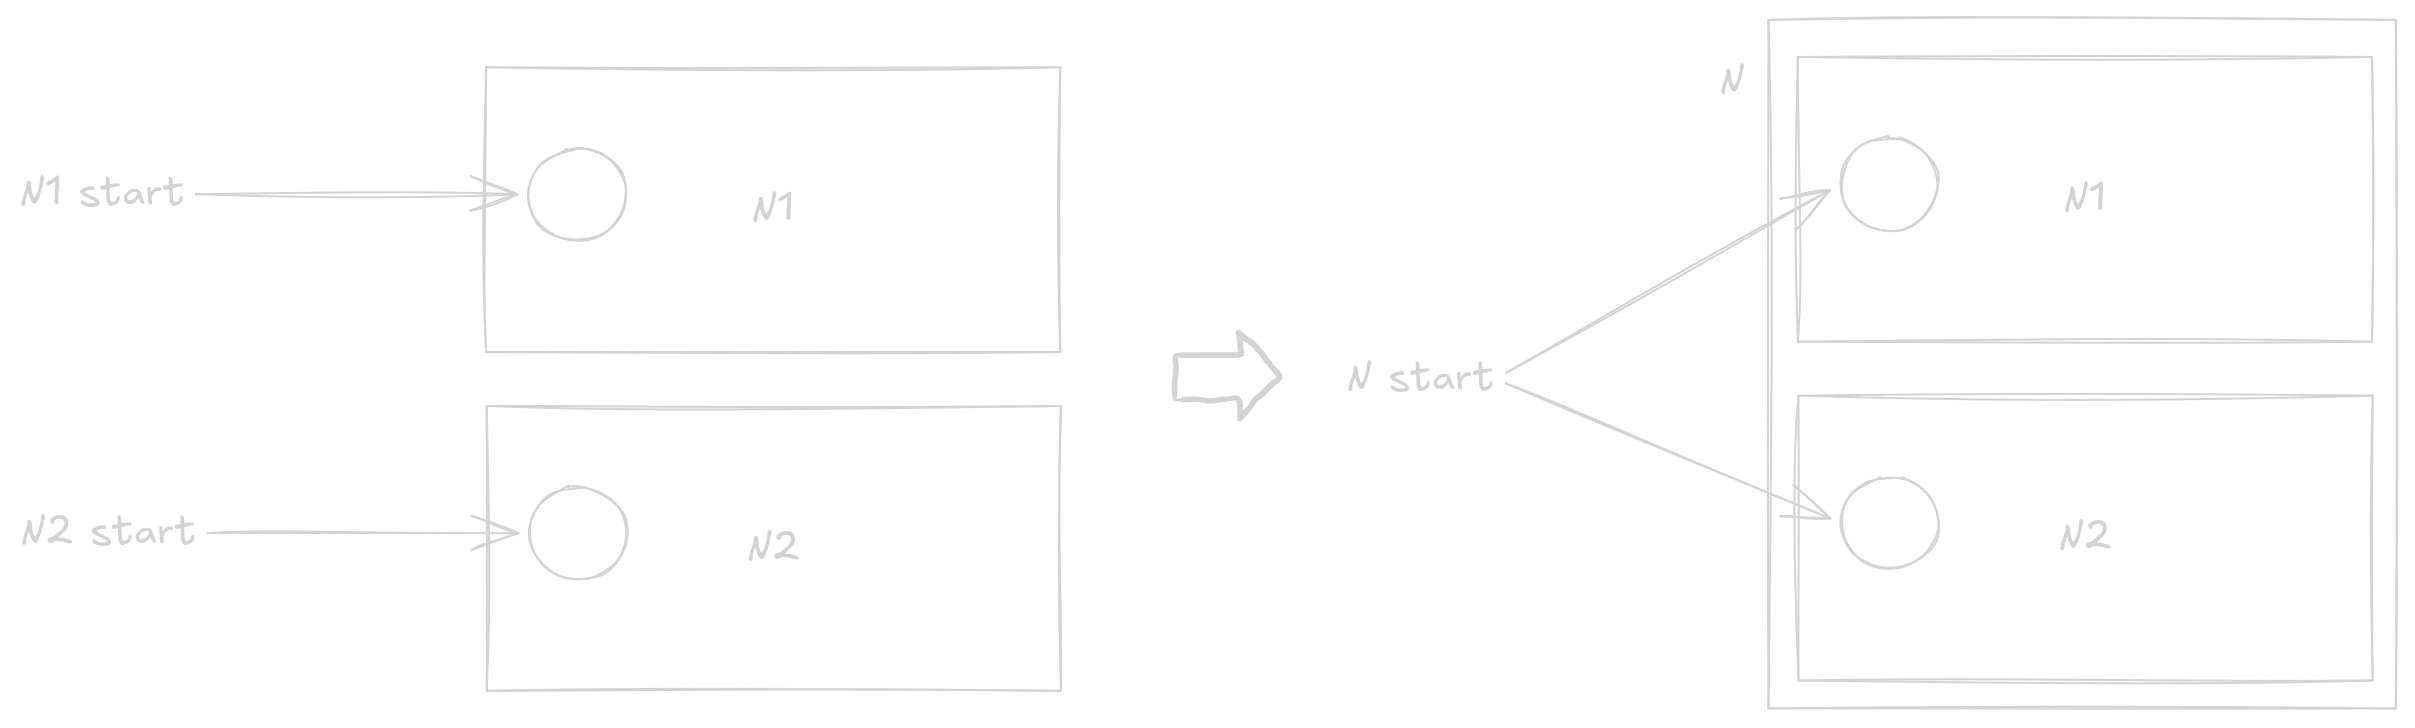
REG è chiuso per
Dati due NFA che riconoscono rispettivamente costruisco un NFA che riconosce .
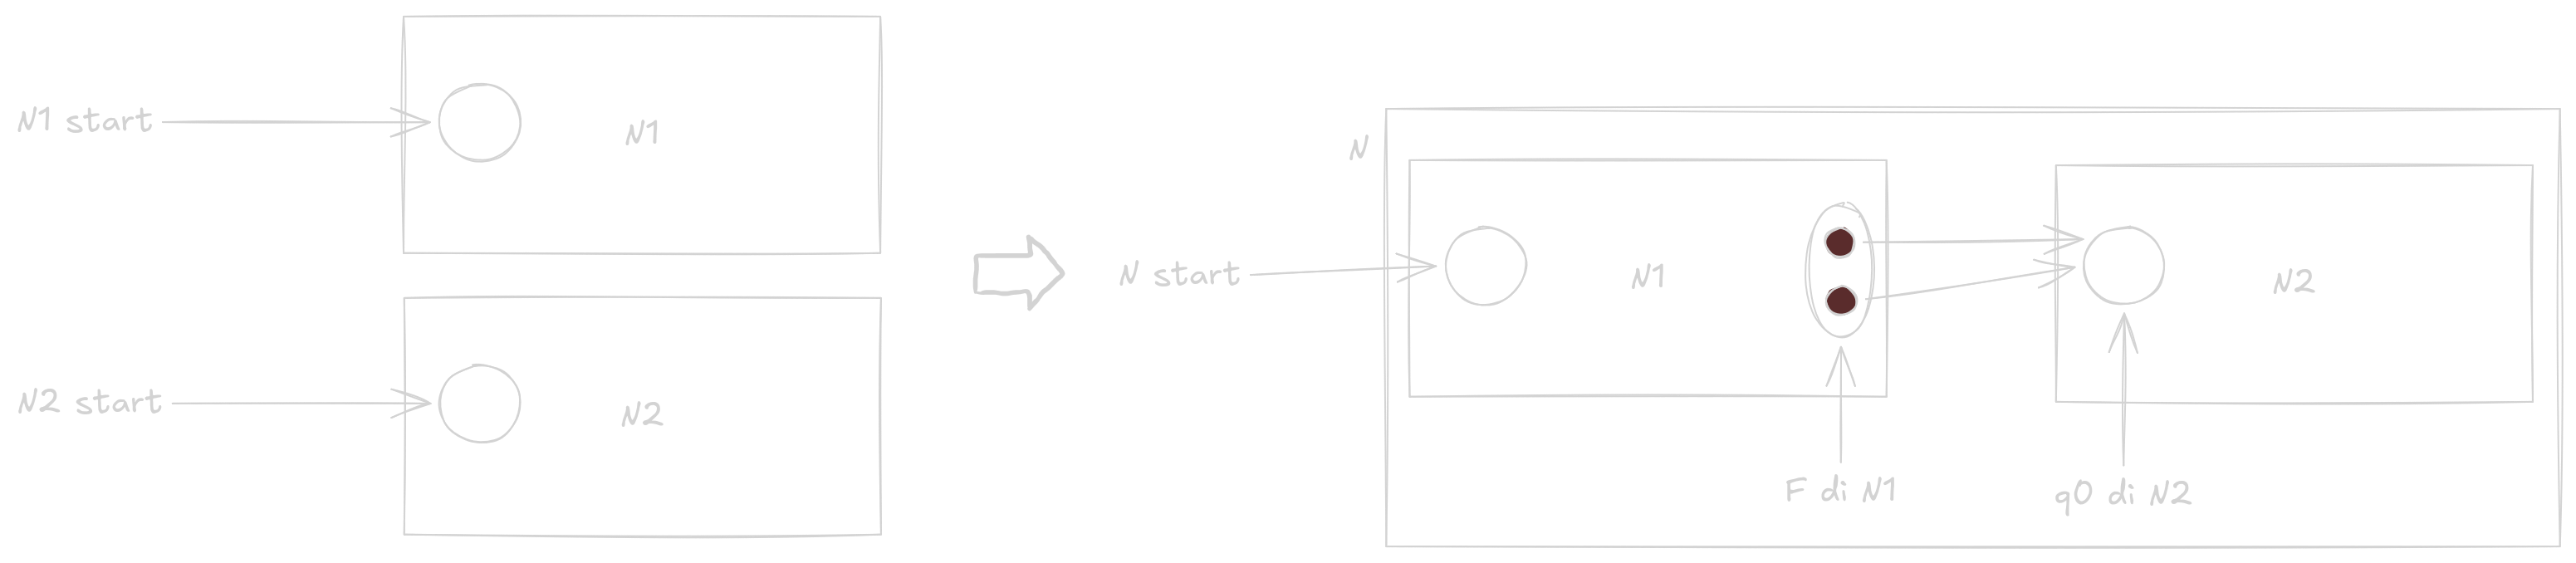
REG è chiuso per (concatenazione)
Dati due NFA che riconoscono rispettivamente costruisco un NFA che riconosce .
REG è chiusa per
Dato un NFA tale che (che riconosce ) costruisco un NFA tale che .
Mettiamo conto che riconosce , implementato con un albero di caratteri:
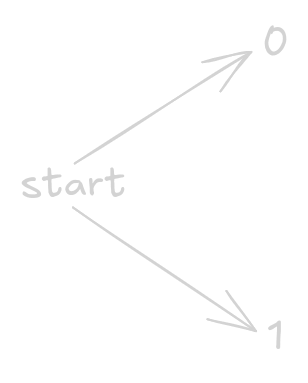
Per fare un DFA che riconosce bisogna copiare l’albero di e “attaccarlo” su ogni sua foglia:
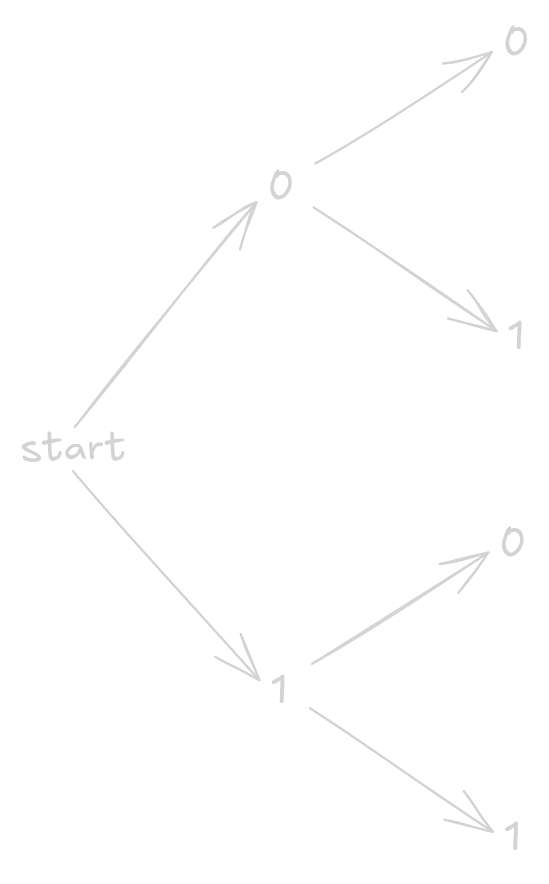
Si potrebbe provare a ripetere il procedimento all’infinito per :
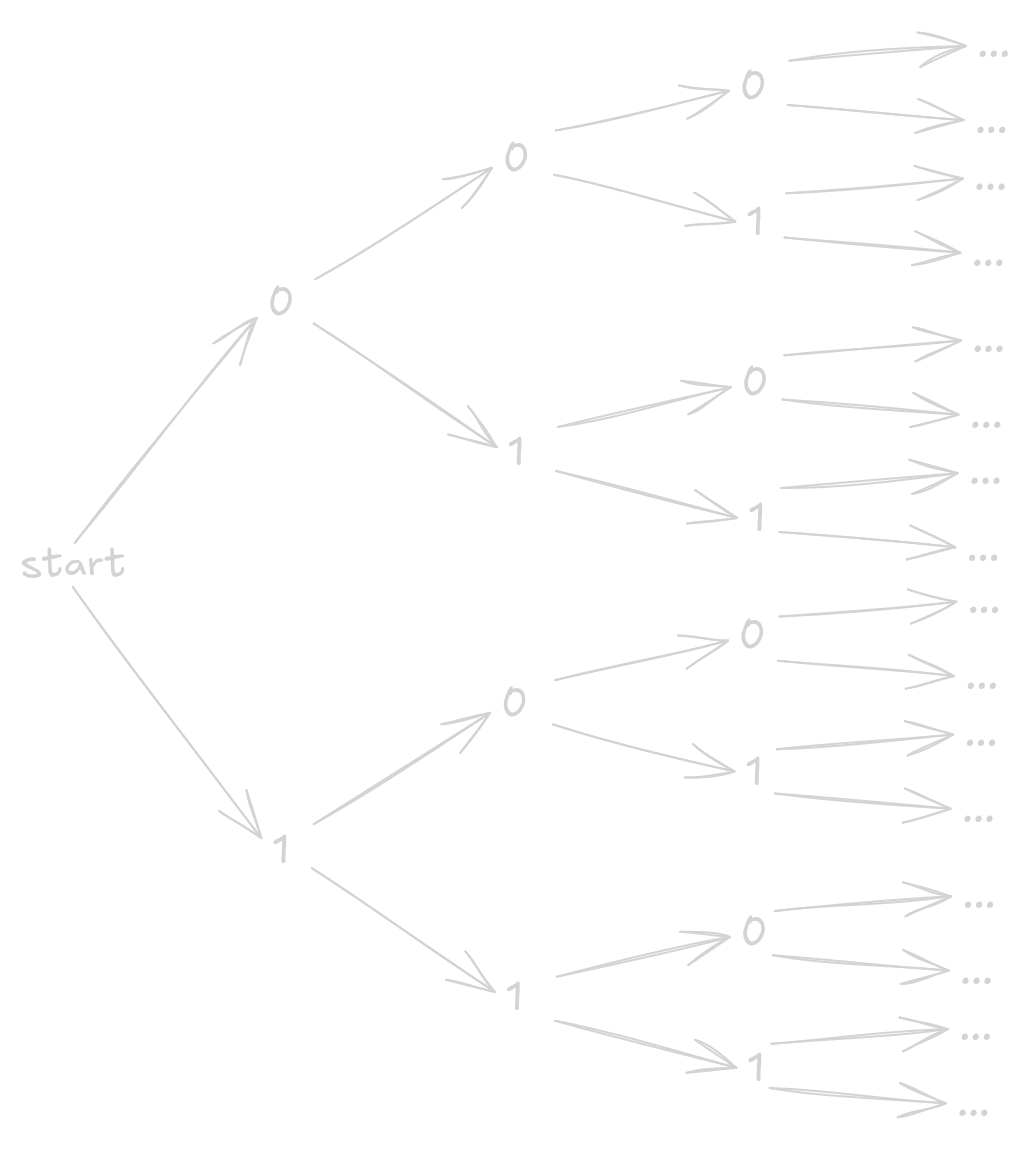
Ma questo non sarebbe un DFA, perché ha stati infiniti.
Però si può costruire un NFA analogo a questo partendo dal caso iniziale :
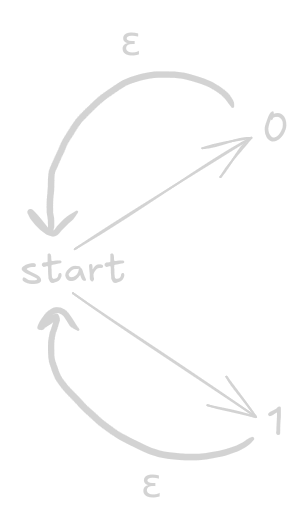
Nel caso generale, vale che: